Cómo tener tu propia AI en un teléfono Android sin necesidad de conexión a la red
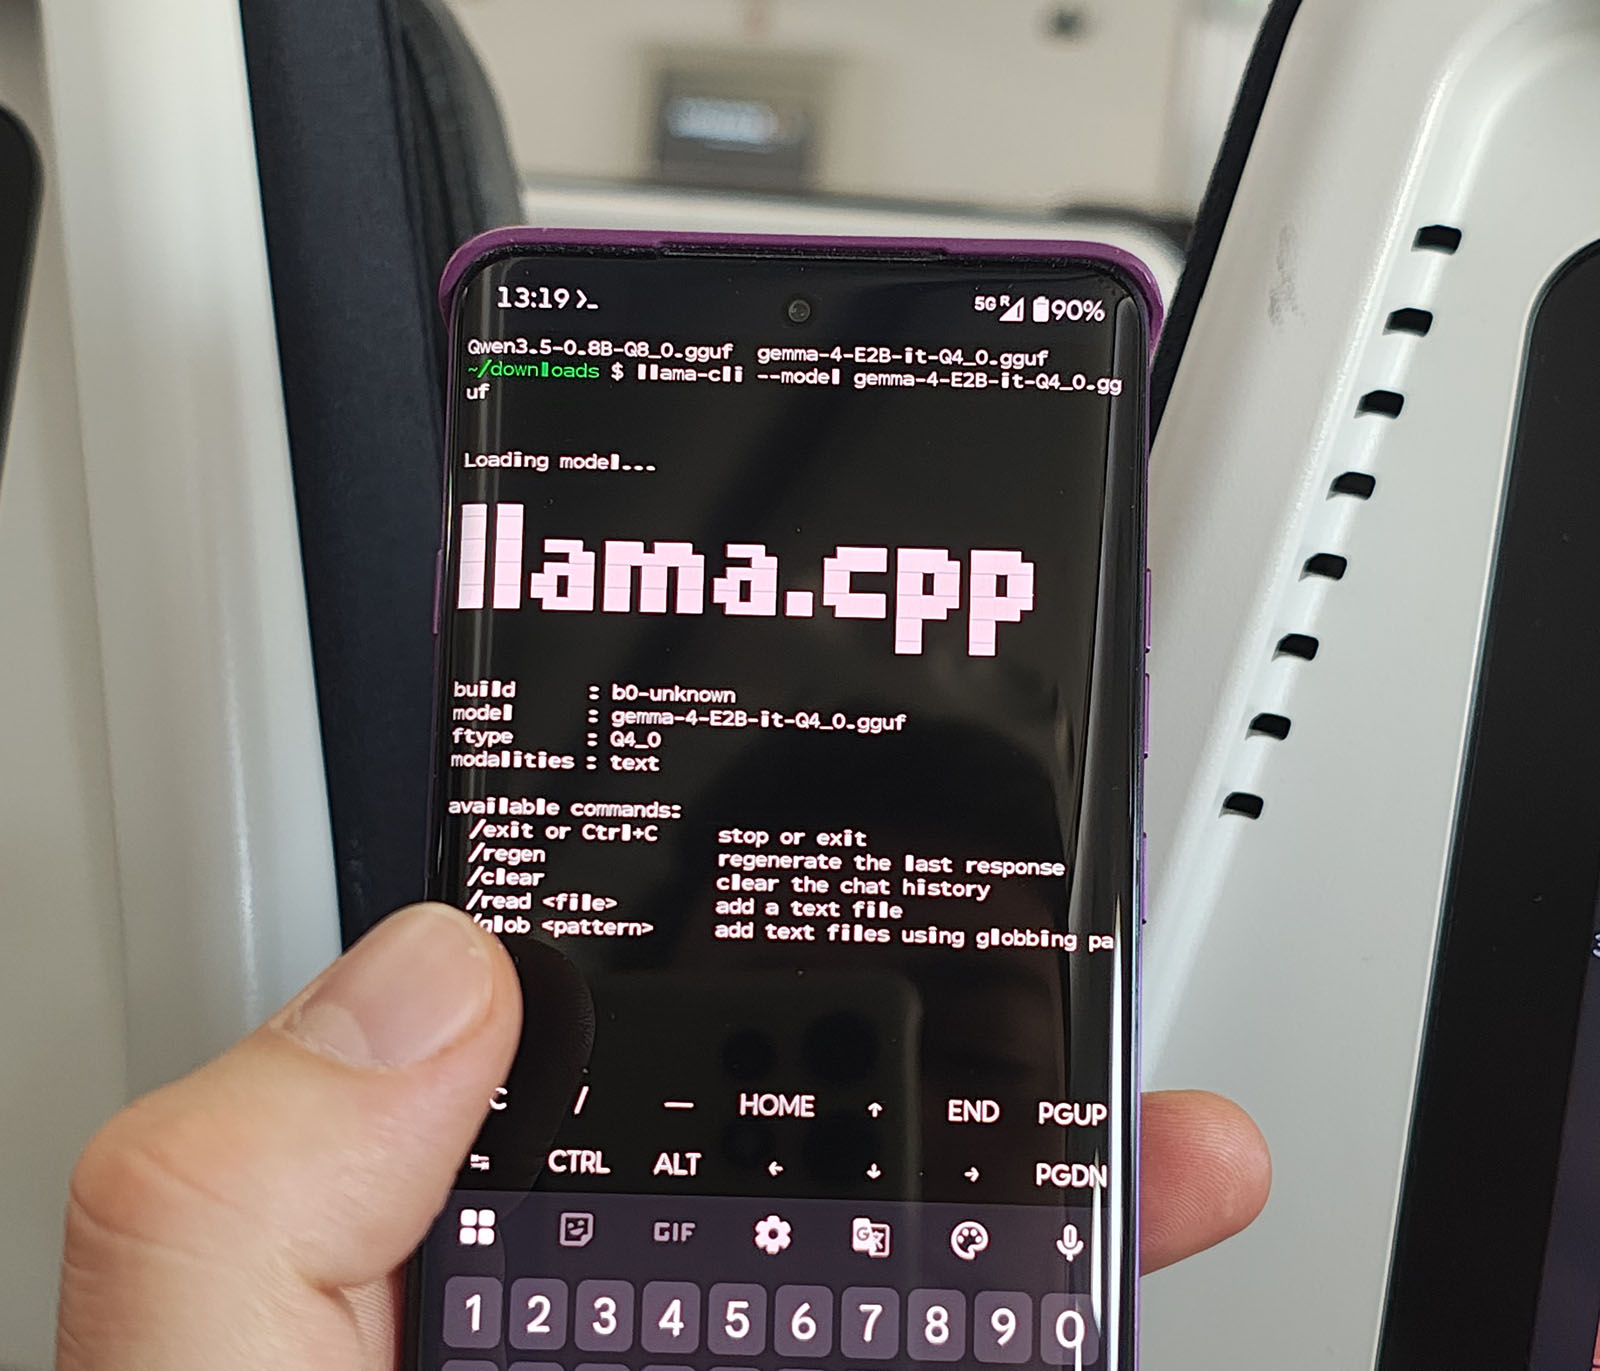
Tenía que tomarme un vuelo y sabía perfectamente que no iba a pagar un céntimo por WiFi durante esas horas, y como sudaca, me toca viajar 12/14 horas. ¿Cómo boludear en el avión con un LLM? Obviamente es posible, inclusive en el celular.
Probé varias opciones, la "abierta" y otra no tanto, así que paso a contarles cómo ejecutar un modelo LLM en un teléfono celular con Android...
La opción Google
Esta es la más sencilla y eficiente para jugar un rato gracias a que Google tiene el modelo Gemma 4 totalmente libre y ya preparado para instalar.
La app que ofrecen es Google AI Edge Gallery (está en la Play Store) y dentro podrás encontrar varios modelos para descargar, obviamente los primeros que te ofrece son los últimos Gemma 4 en versión E2B-IT y E4B-IT, 2.6GB y 3.7GB respectivamente.
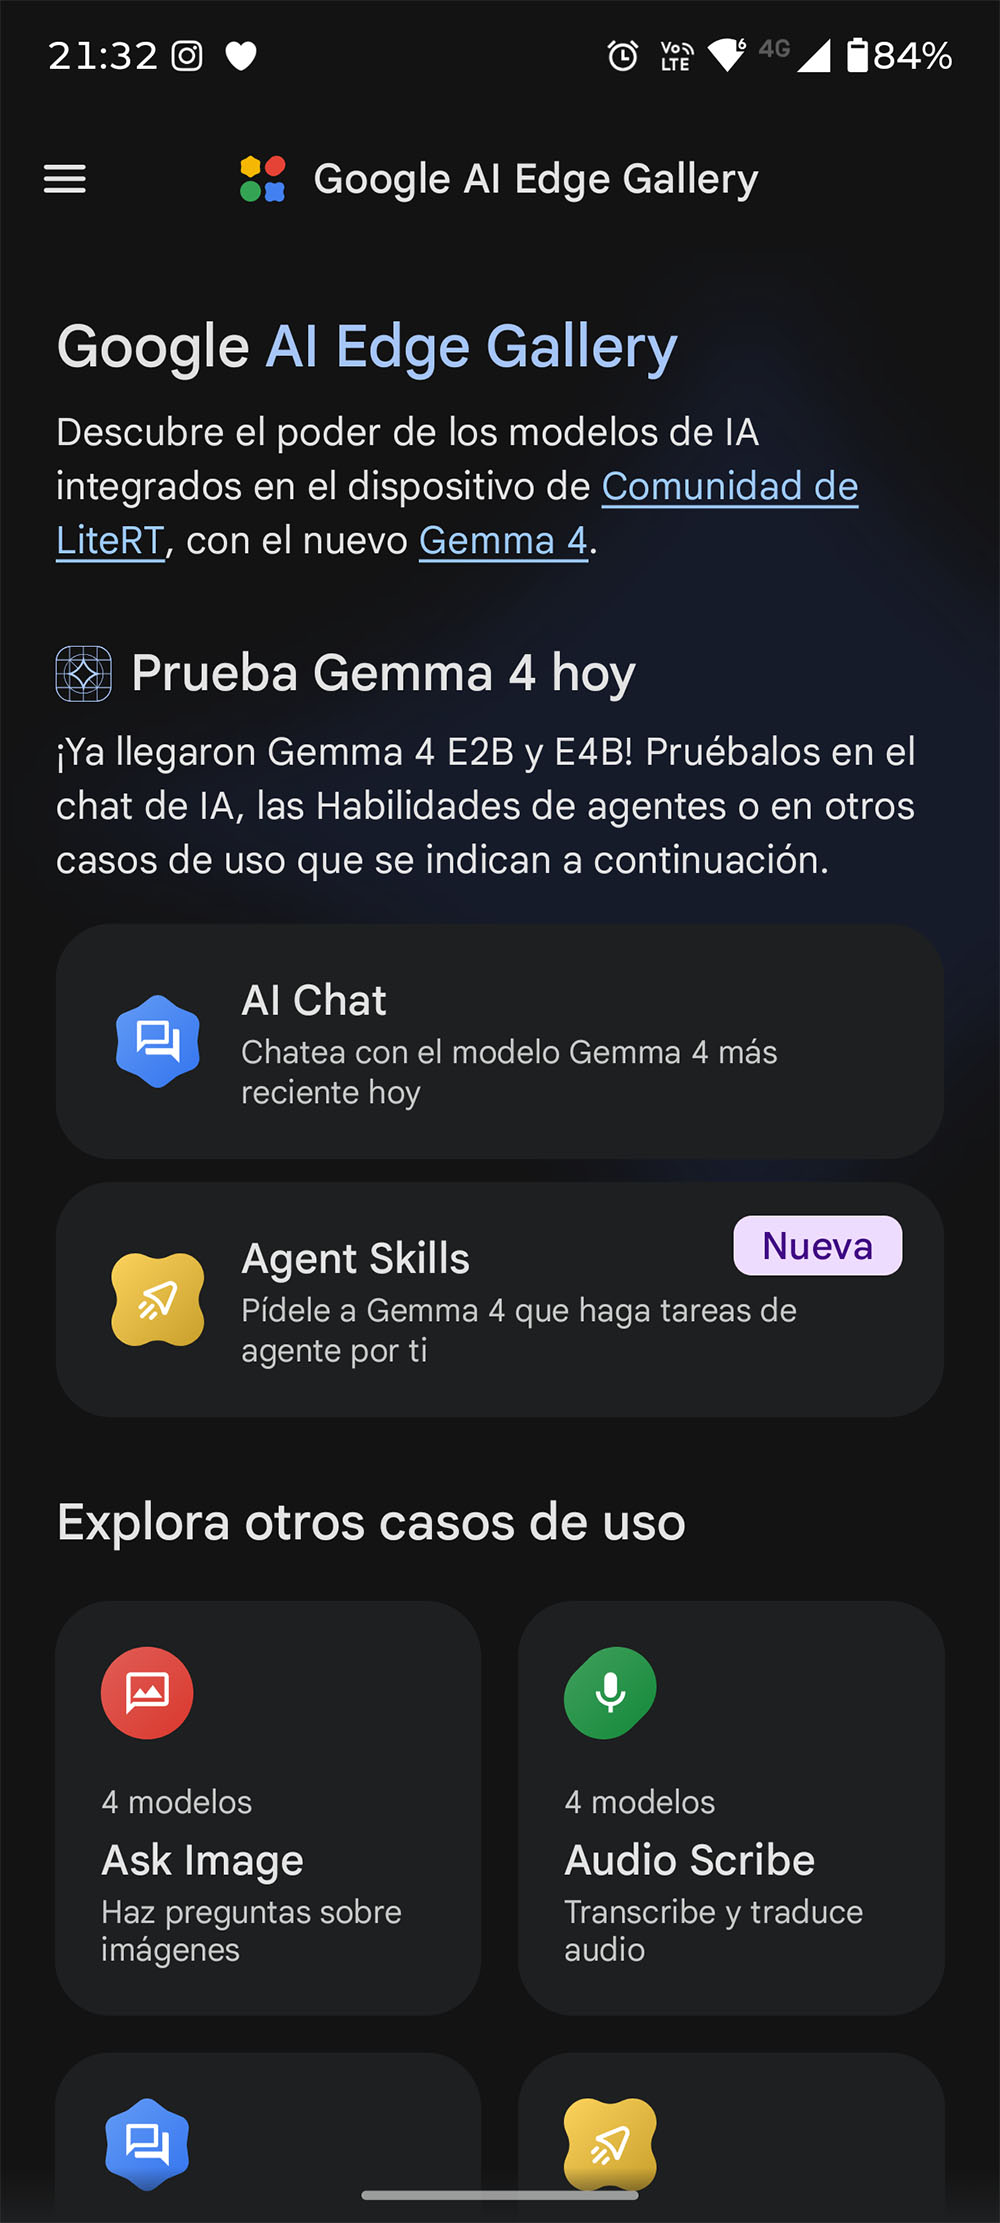
Estos modelos son versiones cuantizadas bien pequeñas que entran en la memoria de un celular de gama media y alta, en mi caso es un Motorola Edge 60 Pro con un MediaTek Dimensity 8350 y 12GB de RAM, más que suficientes como para que entre un modelo de 4GB y el teléfono ni lo note.
El modelo soporta entrada multi-modal y un contexto de 32k tokens, obviamente no esperen "velocidad" porque si algo es limitante en los celulares es el ancho de banda de esa memoria y cómo manejan los núcleos.
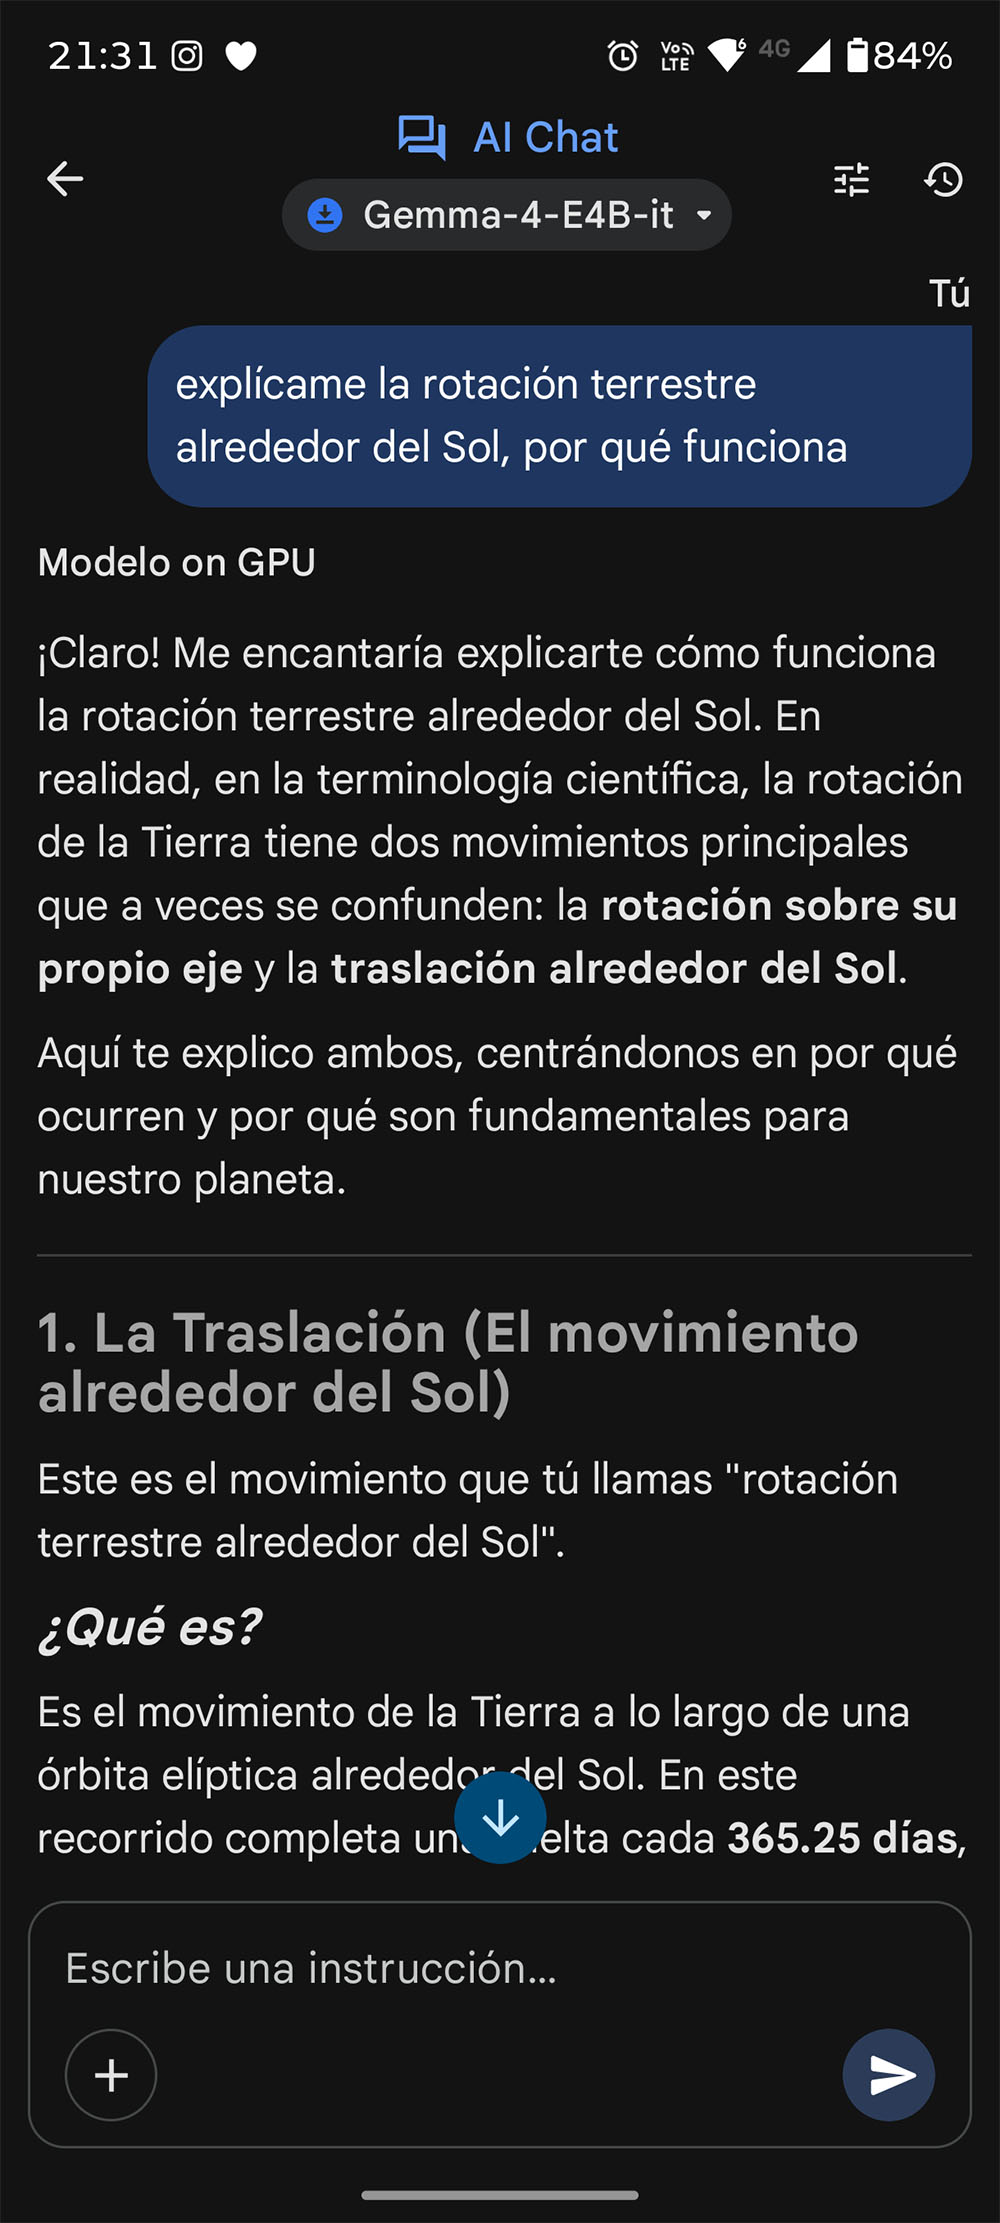
Ventajas de hacerlo con esta app: utiliza el GPU al máximo y sabe identificar correctamente qué CPUs usar, cómo configurar el uso de la memoria y logra devolver más de 10 tokens por segundo sin problemas.
La opción Termux + llama.cpp
La opción más cabeza de termo es Termux, LOL, y el viejo y clásico llama.cpp que depende mucho cómo esté compilado funcionará bien o no en tu teléfono.
En el mío, como era de esperar, con las opciones default era una porquería de lento 
Termux es un emulador de terminal que funciona muy bien para miles de aplicaciones, básicamente sacarle un poco el jugo al linux que hay por detrás del Android que vemos todos los días.
Y casi como una distro, tiene paquetes para cada cosa, así que instalar llama.cpp es trivial:
pkg update && pkg upgrade -y
pkg install llama-cpp -y
Por otra parte, desde el browser del teléfono, pueden descargar un modelo, yo probé con dos, los bajan desde Huggingface como todo modelo.
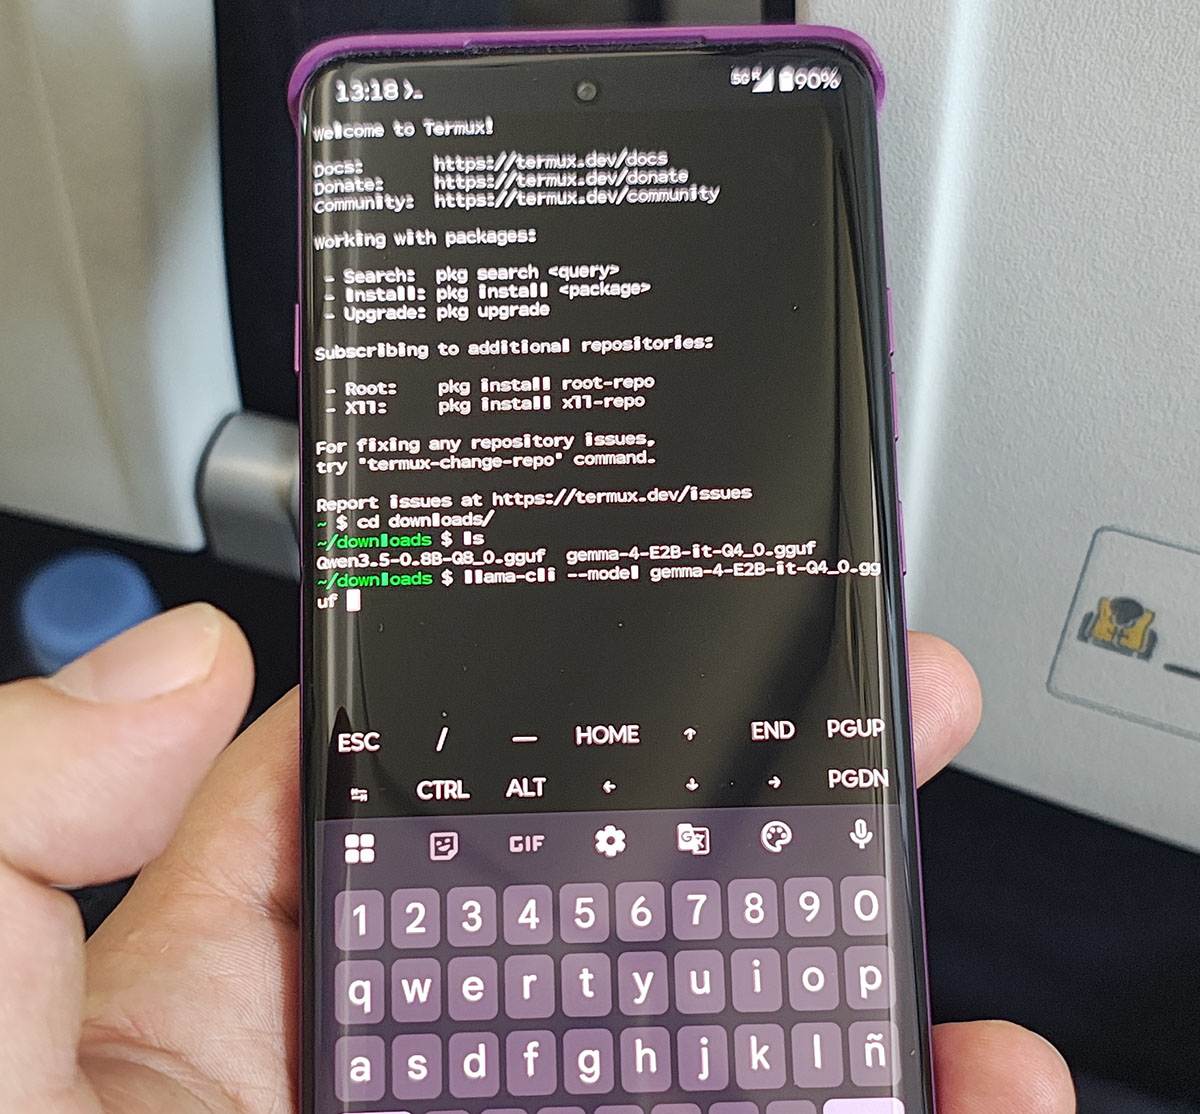
Bajé las versiones GGUF de Qwen3.5-0.8B-Q5_K_M y el mismo Gemma 4 E2B-IT, para probar dos opciones.
Una vez descargado si le hacen click a la descarga pueden indicarle que la abra Termux (open with: Termux), esto hace que el archivo aparezca en /downloads en la terminal de Termux.
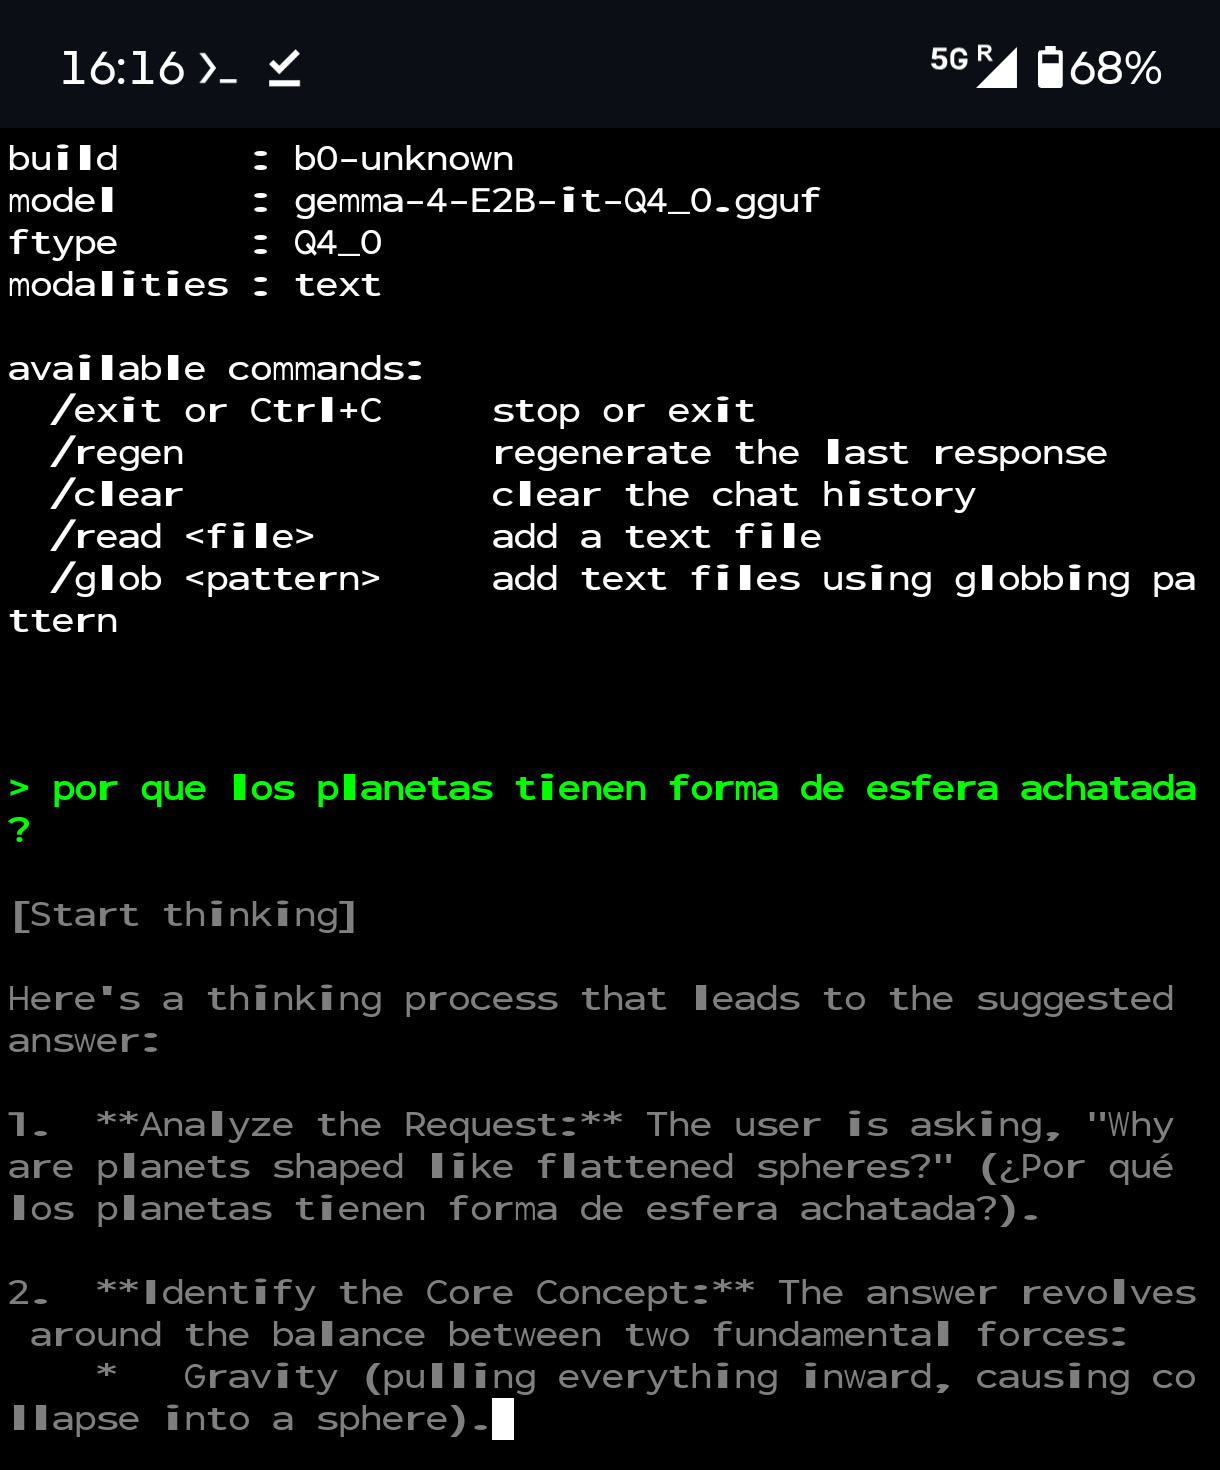
Entramos ahí y ejecutamos de la forma más sencilla del mundo:
llama-cli -m /path/to/model.gguf(si están dentro de Downloads simplemente el nombre del archivo)
Se toma unos segundos en cargar todo en memoria y listo! ya estamos adentro! a preguntarle cosas!
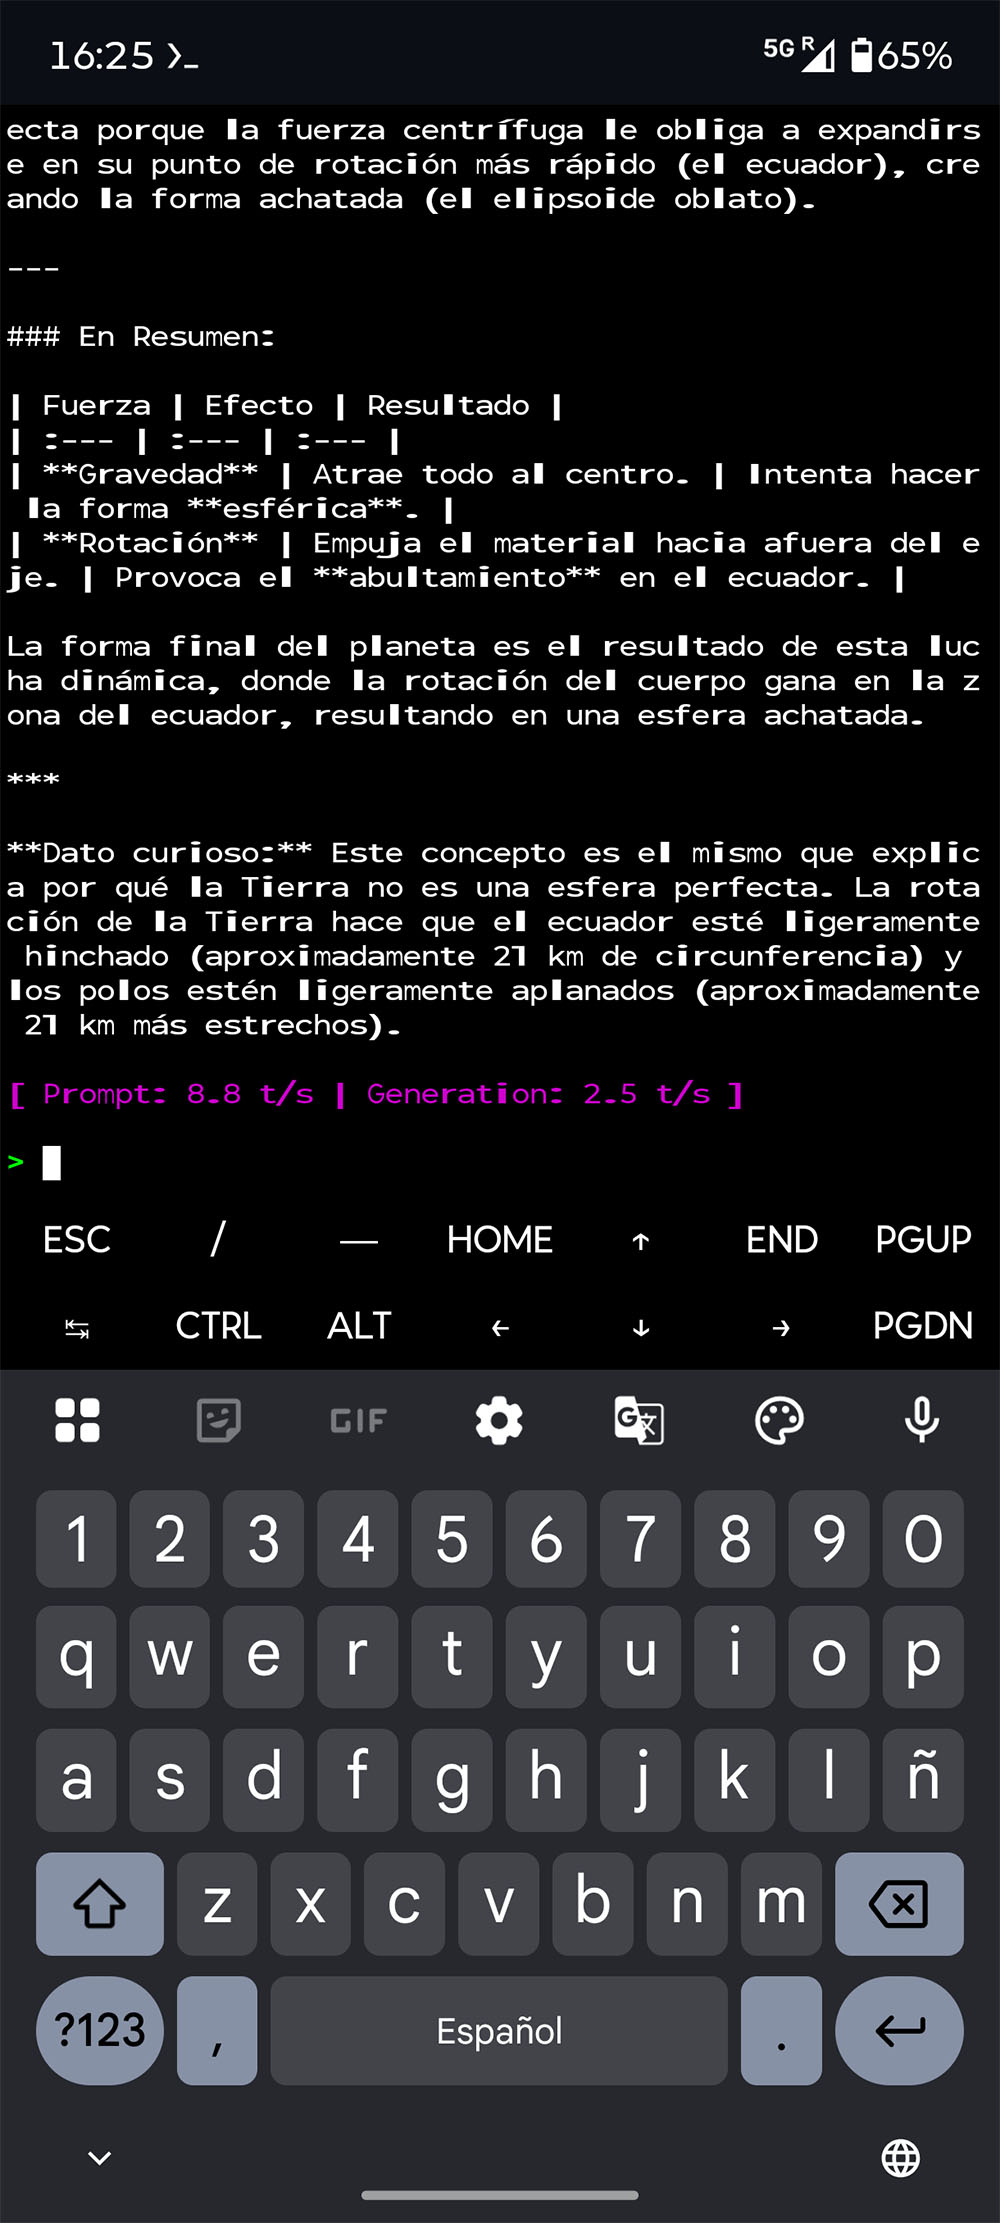
En mi caso fue desastroso, respondía a razón de dos tokens por segundo, obviamente el llama.cpp y las opciones que le pasé estaban mal. Qwen fue mucho peor, entraba en un loop de razonamiento y no salía de ahí, una verga el modelo 
Ventajas de hacerlo con Termux: control total y poder utilizar otros modelos que no son ofrecidos por las apps de sus dueños.
Tu propia compilación
No es nada raro que algunos compilen su propio llama.cpp para que se ajuste a su SoC en particular, se puede instalar cmake para crear una versión propia:
pkg install git cmake clang
git clone https://github.com/ggml-org/llama.cpp && cd llama.cpp
Verificá primero qué soporta tu CPU:
grep -m1 Features /proc/cpuinfo   # buscá "asimddp" e "i8mm"

cmake -B build -DCMAKE_BUILD_TYPE=Release \
  -DGGML_NATIVE=OFF \
  -DGGML_CPU_ARM_ARCH=armv8.2-a+dotprod+i8mm \
  -DGGML_CPU_KLEIDIAI=ON \
  -DLLAMA_CURL=OFF
cmake --build build -j4
Obviamente vas a tener que ir "Claudeando" las opciones que correspondan al SoC que tiene tu teléfono, también hay que tener en cuenta el momento de la ejecución cómo se invoca llama.cpp
Identificá qué cores son los grandes (en MediaTek suelen ser 4-7)
cat /sys/devices/system/cpu/cpu*/cpufreq/cpuinfo_max_freq

termux-wake-lock   # sin esto Android te tira el proceso a los little cores

./build/bin/llama-bench -m modelo.gguf -t 4 -C 0xF0 -fa 1 -mmp 0 -p 128 -n 64
Cuatro puntos que suelen ser la diferencia:
-t 4 -C 0xF0: solo los 4 cores grandes, pineados. Usar los 8 es contraproducente porque los A510 (los núcleos menores) frenan al resto y el scheduler migra threads entre clusters.
--no-mmap / -mmp 0: crítico en Android. Con mmap, ZRAM comprime las páginas del modelo y las descomprime en cada acceso.
-fa 1 + -ctk q8_0 -ctv q8_0: flash attention y KV cache cuantizado.
Contexto chico (-c 4096), y el teléfono enchufado y fresco. Con throttling térmico perdés la mitad de la potencia.
Si, ya me perdí en detalles, pero la idea es exprimir al máximo y luego buscar el modelo más adecuado. GLM no, eso seguro 🤪 y Gemma está bastante bien, pero es lento.
Si te gustó esta nota podés...
Otros posts que podrían llegar a gustarte...


